Große vertrauliche Wissensräume
Verträge, technische Dokumentationen und interne Archive lokal analysieren – kombiniert mit Qdrant und hybrider Suche.
Forschung & Entwicklung · Local AI Lab
AI SolutionX erforscht verteilte lokale KI-Inferenz auf vier NVIDIA DGX Spark. 512 GB Unified Memory, 200-Gbit-Verbindungen und ein 400-Gbit-Switch – für Modelle, die auf keinem einzelnen System Platz finden.
AI SolutionX betreibt in Leonberg einen Forschungsaufbau aus vier NVIDIA DGX Spark, die über ein 400-Gbit-RoCE-Fabric zu einem Inferenzsystem verbunden sind. Per Tensor Parallelism (TP = 4) verteilt SGLang ein einzelnes Sprachmodell auf alle vier Systeme mit zusammen 512 GB Unified Memory; nach außen erscheint der Verbund als ein OpenAI-kompatibler Endpunkt. Ziel ist lokale Inferenz für Modelle, die auf keinem einzelnen System Platz finden. Die auf dieser Seite genannten Durchsatzwerte sind veröffentlichte Referenzwerte der Implementierung von MiaAI-Lab; eigene Reproduktionsmessungen stehen aus.
Stand: · Status: Forschungsaufbau
Nicht vier Server. Ein Rechensystem.
Tensor Parallelism zerlegt ein Modell über alle vier GB10-Systeme. RoCE transportiert die Zwischenergebnisse mit sehr geringer Latenz. Bei AI SolutionX läuft dieser Aufbau unter dem Projektnamen RoCEnante.
Das Modell liegt auf vier Systemen
Vier Shards teilen sich die Gewichte. Jeder Knoten besitzt genau den Teil, den er für seine Berechnung benötigt.
Was die Referenzimplementierung zeigt
Die folgenden Werte stammen aus der veröffentlichten DeepSeek-V4.1-Flash-TP4-Referenz auf vier DGX Sparks über ein geschaltetes RoCE-Fabric. Sie sind keine AISX-eigenen Abnahmemessungen – genau deren Reproduktion ist der nächste Laborschritt. Veröffentlicht als Open-Source-Dokumentation; abgerufen am 2. Oktober 2026.
Quelle und technische Details: MiaAI-Lab · DeepSeek-V4.1-Flash auf 3×/4× DGX Spark
Konkrete Möglichkeiten
Verträge, technische Dokumentationen und interne Archive lokal analysieren – kombiniert mit Qdrant und hybrider Suche.
Architekturen, Abhängigkeiten und Migrationen über umfangreiche Repositories hinweg verstehen, ohne Quellcode nach außen zu übertragen.
Recherche, Bewertung, Synthese und Qualitätskontrolle durch spezialisierte Agenten – über einen zentralen lokalen Modellendpunkt.
Modelle, Logs, Prompts und Zugriffsregeln bleiben in der eigenen Infrastruktur. Planbare Kosten statt tokenbasierter Abhängigkeit.
Nicht jeder Auftrag braucht vier Sparks
Schnelle Einzelmodelle bearbeiten Routineaufgaben. Der Vier-Spark-Verbund übernimmt nur dann, wenn Modellgröße, Qualität oder Kontext es rechtfertigen.
Fast Lane
Für Dialog, Klassifikation, Extraktion und viele parallele Standardanfragen.
Quality Lane
Für sehr große Modelle, lange Kontexte und anspruchsvolle Analyse- oder Coding-Aufgaben.
Technisch ehrlich
Serving-Software und GB10-optimierte Kernel bewegen sich schnell. Deshalb trennt AI SolutionX veröffentlichte Referenzwerte, eigene Reproduktionsmessungen und produktionsreife Freigaben klar voneinander.
Mehrere NVIDIA DGX Spark (GB10, je 128 GB Unified Memory), die über ein schnelles Netzwerk so verbunden sind, dass sie ein Sprachmodell gemeinsam ausführen. In unserem Aufbau sind es vier Systeme mit 200-Gbit-Verbindungen je Pfad und einem 400-Gbit-Switch, zusammen 512 GB Unified Memory.
Ein einzelner DGX Spark hat 128 GB Unified Memory. Modelle, deren Gewichte darüber liegen, passen nicht in den Speicher eines Systems. Tensor Parallelism verteilt die Gewichte auf mehrere Systeme und macht solche Modelle lokal ausführbar.
Jeder der vier Knoten hält einen Teil der Gewichte jedes Transformer-Layers und berechnet seinen Anteil parallel zu den anderen. All-reduce und All-gather führen die Teilergebnisse nach jedem Schritt über das Netzwerk zusammen. Das Modell bleibt dabei logisch eine Einheit.
RoCE steht für RDMA over Converged Ethernet: Systeme schreiben direkt in den Speicher des jeweils anderen, über Ethernet und mit sehr geringer Latenz. RoCEnante ist der von AI SolutionX geprägte Projektname für diese experimentelle Multi-Node-Architektur: vier DGX-Spark-Systeme, verbunden über ein RoCE-fähiges 200-/400-Gbit-Netzwerk.
Die Referenzimplementierung von MiaAI-Lab nennt für vier DGX Spark mit TP = 4 rund 87,7 Tokens pro Sekunde für Prosa und 124,8 für Code in einem einzelnen Stream, 342,7 Tokens pro Sekunde aggregiert über 16 Streams sowie einen bestandenen Needle-Test mit einer Million Tokens Kontext. Das sind veröffentlichte Werte, keine eigenen Messungen von AI SolutionX; deren Reproduktion ist der nächste Schritt.
Der Vier-Spark-Verbund ist ein Forschungsaufbau und kein Standardprodukt. Was wir für Unternehmen bauen, sind On-Premise-KI-Systeme, RAG-Architekturen und individuelle Anwendungen vom einzelnen GPU-Server bis zum verteilten Verbund — in der Regel hybrid: schnelle Einzelmodelle für Routineaufgaben, der Verbund nur dort, wo Modellgröße, Qualität oder Kontext es rechtfertigen.
Ja. Modelle, Logs, Prompts und Zugriffsregeln bleiben in der eigenen Infrastruktur; Anwendungen sprechen einen OpenAI-kompatiblen Endpunkt im eigenen Netz an. Es gibt keine Cloud-API und keine nutzungsabhängige Abrechnung pro Anfrage.
Begriffe dieser Seite erklärt das Glossar.
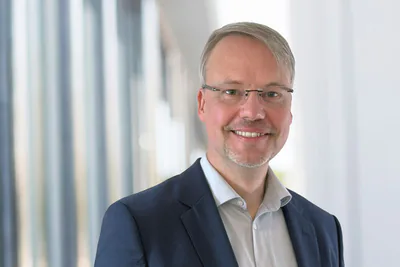
Tobias Plehn, Dipl.-Inf. (FH), Geschäftsführer AI SolutionX, Sachverständiger für Datenschutz, Datensicherheit und Cyber-Security. Verantwortlich für Aufbau und Betrieb der lokalen KI-Plattform.
Local AI. Made in Leonberg.
Wir entwickeln sichere On-Premise-KI-Systeme, RAG-Architekturen und individuelle Anwendungen – vom einzelnen GPU-Server bis zum verteilten Inferenzverbund.
Erstgespräch vereinbaren