Lokale Sprachmodelle für Mitarbeitende
Chatten, Zusammenfassen und Übersetzen über eine Oberfläche wie Open WebUI, mit einem Modell im eigenen Netz. Eingaben und Antworten verlassen das Unternehmen nicht.
Leistungen · Lokale KI-Systeme
Beratung, Einrichtung und Betrieb – vom einzelnen Gerät auf dem Schreibtisch bis zum Verbund aus vier Systemen. Ihre Daten bleiben dabei im Haus.
NVIDIA und DGX Spark sind Marken der NVIDIA Corporation. AI SolutionX ist ein unabhängiger Dienstleister, weder NVIDIA-Partner noch Händler. Die Hardware beziehen Sie über den Fachhandel; wir beraten Sie bei Konfiguration und Bestellumfang.
NVIDIA DGX Spark ist ein kompakter KI-Rechner, in dessen Chip GB10 sich CPU und GPU 128 GB Unified Memory teilen; NVIDIA nennt dafür Sprachmodelle mit bis zu 200 Milliarden Parametern je Gerät. AI SolutionX berät Unternehmen, ob und in welcher Konfiguration ein solches Gerät passt, richtet Einzelgeräte und Verbünde mit einem OpenAI-kompatiblen Endpunkt im eigenen Netz ein und übernimmt auf Wunsch den laufenden Betrieb. Die Hardware beschafft das Unternehmen selbst über den Fachhandel. Einen Verbund braucht es, wenn ein Modell den Speicher eines einzelnen Geräts übersteigt; dann verteilt Multi-Node-Inferenz es auf bis zu vier Geräte. Alle Leistungs- und Speicherwerte auf dieser Seite sind Herstellerangaben von NVIDIA, keine eigenen Messungen.
Stand:
Das Gerät
Der DGX Spark ist für Entwicklung und Betrieb lokaler Sprachmodelle gebaut. Entscheidend ist der gemeinsame Speicher: Er bestimmt, wie groß ein Modell sein darf, das auf dem Gerät läuft.
Herstellerangaben NVIDIA, Quellen am Seitenende. * FP4 mit Sparsity laut NVIDIA.
Bedarfsklärung und Konfiguration
Bevor Hardware bestellt wird, klären wir, was darauf laufen soll. Am Ende steht eine Konfiguration mit Begründung – oder die Empfehlung, einen anderen Weg zu gehen.
Ein Unternehmen will ein Sprachmodell im eigenen Haus betreiben und weiß nicht, ob dafür ein Gerät genügt oder ein Verbund nötig ist. Nach der Beratung liegt eine Konfiguration vor, die begründet, warum sie zu den geplanten Modellen und Nutzern passt.
Einrichtung und Inbetriebnahme
Wir richten Betriebssystem, Modell-Serving und Zugriffe so ein, dass Anwendungen im Unternehmensnetz das Modell über eine einzige Schnittstelle ansprechen.
Die Geräte sind geliefert, aber in der IT hat noch niemand Sprachmodelle für den produktiven Einsatz bereitgestellt. Nach der Einrichtung sprechen die Anwendungen einen Endpunkt im eigenen Netz an, und die Messwerte der Abnahme liegen dokumentiert vor.
Betrieb und Support
Sprachmodelle und Serving-Software entwickeln sich schnell. Wir halten das System aktuell und prüfen jede Änderung, bevor sie in den Betrieb geht.
Das System läuft, aber im Haus kann es niemand pflegen. Wir übernehmen Updates, Modellwechsel und Überwachung; die Daten bleiben im Unternehmensnetz.
Typische Einsatzfelder
Sechs Aufgaben, für die ein einzelnes Gerät oder ein kleiner Verbund in Frage kommt. Welche davon bei Ihnen trägt, klärt die Beratung.
Chatten, Zusammenfassen und Übersetzen über eine Oberfläche wie Open WebUI, mit einem Modell im eigenen Netz. Eingaben und Antworten verlassen das Unternehmen nicht.
Handbücher, Verträge und Richtlinien werden per Retrieval-Augmented Generation in natürlicher Sprache abfragbar. Jede Antwort nennt die Fundstelle, aus der sie stammt.
Mehrstufige Abläufe wie Recherche, Bewertung und Entwurf laufen über einen lokalen Modellendpunkt. Jeder Schritt lässt sich protokollieren und nachvollziehen.
Entwicklungsteams testen Modelle, Prompts und Anwendungen lokal und vergleichen Varianten mit Daten aus dem eigenen Haus. In Produktion geht erst, was sich dabei bewährt hat.
Ein vorhandenes Modell wird mit eigenen Beispielen auf Fachsprache oder wiederkehrende Aufgaben zugeschnitten. NVIDIA nennt für ein Gerät die Feinabstimmung von Modellen bis 70 Mrd. Parametern (Herstellerangabe).
Whisper verschriftet Besprechungen und Diktate lokal, Embedding-Modelle machen Texte für die Vektorsuche auffindbar. Beides kann neben dem Sprachmodell auf demselben Gerät liegen, solange der gemeinsame Speicher reicht.
Ein Gerät oder Verbund
Ein einzelner DGX Spark hält Modelle, die in seine 128 GB passen. Größere Modelle brauchen einen Verbund, der die Gewichte auf mehrere Geräte verteilt. AI SolutionX betreibt einen solchen Verbund aus vier Systemen als Forschungsaufbau.
Vom einzelnen Spark zum Verbund
Mit jedem Gerät wächst der gemeinsame Speicher – und damit die Modellgröße, die lokal ausführbar bleibt.
* Die 64-GB-Speicherkonfiguration ist exklusiv über teilnehmende OEM-Partner verfügbar.
Software-Stack
Vier Ebenen, von der Hardware unten bis zur Anwendung oben. AI SolutionX richtet alle Ebenen oberhalb der Hardware ein und betreibt sie auf Wunsch; die Hardware selbst beziehen Sie über den Fachhandel.
Herstellerangaben
Wie viele Geräte sich verbinden lassen, wie sie verkabelt werden und welche Modellgrößen NVIDIA dafür nennt.
| Geräte | Verbindung | Speicher zusammen | Hinweis |
|---|---|---|---|
| 1 | keine – Einzelgerät | 128 GB | Inferenz mit Modellen bis zu 200 Mrd. Parametern |
| 2 | direkt verkabelt über ConnectX-7 (QSFP) | 256 GB | Modelle bis zu 400 Mrd. Parametern |
| 3 | direkt verkabelt | 3 × 128 GB | Höchstzahl für direkte Verkabelung; eine Modellgröße nennt NVIDIA dafür nicht |
| 4 | über einen Switch | 512 GB | Modelle bis zu 700 Mrd. Parametern; Höchstzahl des NVIDIA-Einrichtungswerkzeugs |
Speicher und Modellgrößen laut NVIDIA-Produktseite, Verkabelung laut DGX Spark User Guide; Quellen am Seitenende. Im Verbund hält jedes Gerät seinen Teil des Modells im eigenen Speicher.
Der Vier-Spark-Verbund läuft bei AI SolutionX als Forschungsaufbau und ist kein Standardprodukt. Für Unternehmen raten wir zu einem Verbund nur dort, wo Modellgröße, Qualität oder Kontext es rechtfertigen – Routineaufgaben erledigt ein einzelnes Gerät.
Ein DGX Spark ist ein guter Baustein für lokale KI, aber nicht für jede Aufgabe der richtige.
Welcher Weg zu Ihrem Fall gehört, sagen wir Ihnen in der Beratung, auch wenn es nicht der DGX Spark ist. Oft ist es eine Kombination: lokal für Vertrauliches, eine europäische Cloud für Lastspitzen oder sehr große Modelle.
Lokale KI vs. Cloud-KI: der Vergleich → Amazon Bedrock einrichten Alle Leistungen
Ein kompakter KI-Rechner von NVIDIA für Schreibtisch oder Serverrack, 150 × 150 × 50,5 mm groß und 1,2 kg schwer. Im Chip GB10 teilen sich eine Arm-CPU mit 20 Kernen und eine GPU der Blackwell-Generation 128 GB Unified Memory. Nach Angabe von NVIDIA führt ein Gerät Sprachmodelle mit bis zu 200 Milliarden Parametern aus.
Für Unternehmen, die Sprachmodelle im eigenen Haus betreiben wollen, weil ihre Daten das Unternehmen nicht verlassen sollen, und bei denen eine kleine bis mittlere Zahl von Mitarbeitenden gleichzeitig damit arbeitet. Er eignet sich außerdem für Entwicklung und Erprobung, bevor ein Modell in Produktion geht. Für viele gleichzeitige Nutzer mit hohem Durchsatz sind Server mit mehreren GPUs die bessere Wahl.
Das entscheidet die Größe der Modelle, die Sie einsetzen wollen. Passt ein Modell samt Kontext in die 128 GB eines Geräts, genügt eines; sollen nur mehr Anfragen gleichzeitig bedient werden, helfen mehrere unabhängige Geräte. Einen Verbund braucht es erst, wenn ein einzelnes Modell den Speicher eines Geräts übersteigt. Diese Abwägung ist der Kern unserer Beratung.
Laut NVIDIA-Handbuch unterstützt das Einrichtungswerkzeug bis zu drei direkt verkabelte Geräte und bis zu vier über einen Switch. Verbunden werden sie über die ConnectX-7-Netzwerkkarte mit zwei QSFP-Anschlüssen à bis zu 200 Gbit/s. Für vier Geräte nennt NVIDIA Modelle mit bis zu 700 Milliarden Parametern; das ist eine Herstellerangabe, keine eigene Messung.
Nein. AI SolutionX ist ein unabhängiger Dienstleister und weder NVIDIA-Partner noch Händler. Sie beziehen die Geräte über den Fachhandel; wir beraten Sie vorher bei Konfiguration und Bestellumfang, damit Geräte, Kabel und gegebenenfalls der Switch zueinander passen.
Wenn das System bei Ihnen im Haus steht, ja: Modelle, Eingaben, Protokolle und Zugriffsregeln bleiben im Unternehmensnetz, und Anwendungen sprechen einen Endpunkt in Ihrem eigenen Netz an. Betreiben wir das System in unserer Infrastruktur, verlassen die Daten Ihr Haus, bleiben aber in Deutschland. Welches Betriebsmodell zu Ihrem Schutzbedarf passt, klären wir vorab.
Als Betriebssystem NVIDIA DGX OS. Darauf richten wir ein Modell-Serving mit Ollama, vLLM oder SGLang ein, das einen OpenAI-kompatiblen Endpunkt bereitstellt, dazu je nach Bedarf Open WebUI als Oberfläche, Qdrant für Wissens-KI und Whisper für Transkription. Welche Kombination passt, hängt von Ihren Modellen und Anwendungen ab.
Wir rechnen nach Aufwand ab. Der hängt davon ab, wie viele Geräte eingerichtet werden, welche Modelle und Anwendungen laufen sollen und ob Sie den Betrieb selbst übernehmen oder an uns geben. Den Umfang klären wir im Erstgespräch; die Geräte selbst kaufen Sie im Fachhandel, ihr Preis ist nicht Teil unseres Angebots.
Begriffe dieser Seite erklärt das Glossar.
Herstellerangaben NVIDIA
| Chip | NVIDIA GB10 Grace Blackwell Superchip |
|---|---|
| CPU | 20 Arm-Kerne: 10× Cortex-X925, 10× Cortex-A725 |
| GPU | Blackwell-Generation |
| Speicher | 128 GB LPDDR5x, kohärent für CPU und GPU (Unified Memory) |
| Speicherbandbreite | 273 GB/s |
| KI-Leistung | bis zu 1 PFLOP FP4 (mit Sparsity) |
| Netzwerk | 10-Gigabit-Ethernet; ConnectX-7 mit 2× QSFP, bis zu 200 Gbit/s je Port (abhängig vom Kabel) |
| Maße | 150 × 150 × 50,5 mm |
| Gewicht | 1,2 kg |
| Betriebssystem | NVIDIA DGX OS |
Neben der Ausführung mit 128 GB nennt NVIDIA eine Speicherkonfiguration mit 64 GB, die ausschließlich über teilnehmende OEM-Partner erhältlich ist. Die FP4-Leistung gibt NVIDIA unter Verwendung der Sparsity-Funktion an.
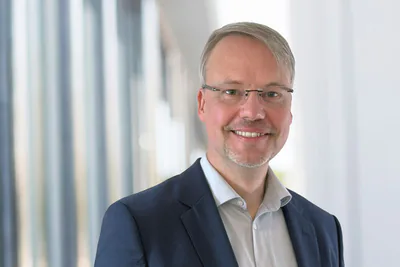
Tobias Plehn, Dipl.-Inf. (FH), Geschäftsführer AI SolutionX, Sachverständiger für Datenschutz, Datensicherheit und Cyber-Security. Verantwortlich für Aufbau und Betrieb der lokalen KI-Plattform.
Beratung · Einrichtung · Betrieb
Im Erstgespräch klären wir, welche Modelle Sie einsetzen wollen, ob ein Gerät reicht und wer das System betreibt. Danach wissen Sie, ob DGX Spark der richtige Weg für Sie ist.
Erstgespräch vereinbaren